В этой статье мы поговорим о том, как кодируется текст в современных компьютерах, а также о таких понятиях, как Unicode, UTF-8 и ASCII (и не только).
Это запись по следам видеоурока, который можно найти на YouTube:
Эта запись также доступна в канале Telegram “DEV: Рубиновые тона”, а обсудить же эту тему можно в нашем чате Telegram. Статья написана с использованием руководства Джоэля Спольского.
Зачем нужны кодировки?
Люди говорят, думают и пишут на естественных языках, многие из которых развивались на протяжении столетий. Конечно, и в мире IT мы хотели бы работать с текстовой информацией в привычном виде, но проблема заключается в том, что современные компьютеры понимают только нолики и единички: да — нет, правда — ложь, есть сигнал — нет сигнала. Впрочем, зачастую и людям тоже проще мыслить категориями “плохо — хорошо”, а не разбираться в “градациях серого” некоего явления (о том, к чему это иногда приводит, я здесь рассуждать не буду). Так или иначе, наши тексты нужно каким-то образом хранить в цифровом виде, и сегодня мы попробуем понять, какие для этого используются подходы.
Разбираться во всём этом действительно полезно, потому что разных языков в мире очень много, вопрос интернационализации (про то, что это такое, я писал в другой статье) и локализации весьма актуален.
Стандарт ASCII
Как работает ASCII?
Перенесёмся в стародавние времена, на целых сорок лет назад (считая от 2024 года — даты публикации этой статьи), когда была написана первая версия книги по языку C, а мир вообще был проще, трава зеленее, да и пиво не разбавляли. Основное внимание тогда уделяли обычным латинским символам безо всяких изысков, то есть без умляутов и прочего. Для них использовался стандарт кодировки ASCII (American Standard Code for Information Interchange), который изначально появился ещё в 60-каком-то-бородатом году.
Суть данного стандарта проста: каждую букву можно закодировать неким целым неотрицательным числом, к примеру “A” — это 65, “B” — 66, и так далее. Это можно проверить и сейчас, к примеру написав "A".ord в Ruby (хотя тут есть особенность, об этом позднее). Кстати, заметим, что тип char в C — это фактически просто целое число. Так вот, каждая буква латинского алфавита и некоторые другие символы типа восклицательных/вопросительных знаков, математических операторов и прочего, кодировались числами от 32 до 126 (127 — это управляющий символ DEL). Это, ясное дело, прекрасно влезало в семь бит. Ну, а так как компьютеры оперировали и восемью битами безо всяких проблем, то оставался ещё целый свободный бит, с помощью которого можно было воплотить в жизнь самые сокровенные и запретные фантазии.
Коды от 0 до 31 включительно использовались для всяких тёмных делишек и назывались “контрольные символы” (aka “непечатные”). К примеру, один из символов мог заставить компьютер пищать в самом прямом смысле, другой означал табуляцию, и так далее (про \n, \t и прочие штуки, думаю, все знают). Найти список всех кодов можно в интернете.
Использование ASCII для разных алфавитов
В общем, всё работало прекрасно, но только для тех, кто использовал английский язык. Естественно, многим пришла в голову простая мысль: “Раз коды от 128 до 255 ни для чего не используются, то их можно задействовать под что угодно!”. К сожалению, понятие “что угодно” у всех разное. Так, в IBM-PC эти коды выводили на экран всякие чёрточки, загогулины и символы квадратного корня (вот тут весь набор). В других же системах ситуация могла быть совершенно иной, и это частенько приводило ко всяким неприятностям. К примеру, если на некоторых компьютерах код 130 выводил é, то на компьютерах, продающихся в Израиле, это число кодировало букву гимель ג. Получалось, что документ, составленный в США и отправленный в Израиль, мог неправильно выводится на тамошних компьютерах (вспомним о таком слове, как “résumé”).
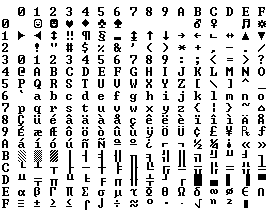
С кириллическими символами тоже была целая история. На излёте СССР был принят ГОСТ, вводивший кодировку КОИ8, совместимую с ASCII, а придумал её мэтр Чернов, который, к сожалению, скончался несколько лет тому назад. КОИ8 как раз задействовала “лишние” коды начиная со 128-го. Были разновидности этой кодировки, например, KOI8-RU, предназначенная сразу для русского, украинского и белорусского языков.
Кодовые страницы и ANSI
В итоге весь этот хаос с “лишними” кодами надо было хоть как-то упорядочить. Так появились многочисленные кодовые страницы (code pages, или cp) — таблицы, определяющие, какие символы соответствуют тем или иным числовым значениям. При этом первые 128 значений обычно оставались совместимыми с ASCII, а вот с кодами от 128 и далее начиналось настоящее веселье: туда запихивали дополнительные латинские символы, буквы национальных алфавитов и прочую красоту.
В Windows такие кодовые страницы часто называли ANSI code pages, хотя никакой единой кодировки ANSI на самом деле не существовало. ANSI (American National Standards Institute) — это вообще-то организация по стандартизации, а не название кодировки, но термин прижился, и попробуй теперь от него избавься.
Поэтому на территории бывшего СССР многие нежно любили кодировку Windows-1251 ровно потому, что 1251 — это номер соответствующей страницы с кириллическими символами. В Израиле для иврита использовалась страница 1255, в Греции — 1253, и так далее. Таких таблиц было выше крыши, а некоторые страницы могли использоваться сразу для нескольких языков, но универсального решения всё равно не получалось.
Проблема с таким новаторским подходом в том, что одновременно можно использовать только одну страницу, то есть по-человечески работать сразу, например, с русским языком и ивритом на одном компьютере было нереально. Ну, разве что писать собственную программу и отображать некоторые символы в каком-то хитром виде.
В Азии же вообще царил трэш и угар, потому что в тамошних странах используются разнообразные иероглифы и всякие сложные закорючки, коих существует значительно больше 9000 — понятное дело, что в 8 бит это никак не уместить. Приходилось идти на всякие ухищрения и хранить некоторые символы в виде одного байта, а некоторые — в виде двух, что весьма усложняло работу со строками (к примеру, не вполне ясно, как двигаться в строке назад). Да, конечно, для всего этого существовали вспомогательные функции, но в целом ситуация была так себе. Тем более, активно развивался интернет, тексты передавались с компьютера на компьютер, и нужно было этот бардак как-то разгребать.
Стандарт Unicode
Тогда появился Unicode, стандарт, цель которого была ввести единую кодировку для всех алфавитов, которые используются на планете (никаких клингонских языков там изначально, видимо, не планировалось, но в целом можно добавить и их тоже).
Подход Unicode существенно отличался от того, что было раньше. Как мы уже выяснили, в ASCII ситуация простая: есть буква “A” латинского алфавита и есть её представление в виде битов 0100 0001, всё просто. В Unicode же букве сопоставляется code point (кодовая точка), которая в свою очередь имеет определённое представление в памяти или на диске, и это представление чётко не регламентировано.
Буквы и их внешний вид
Прежде, чем двигаться дальше, есть один важный момент, который следует уяснить. Мы понимаем, что латинская буква “A” — это не то же самое, что латинская “B”. Отличается она и от строчной буквы “a”, так ведь? Но при этом латинская “А”, написанная курсивом или полужирным шрифтом, — это то же самое, что просто латинская “A”. Больше того, “А”, написанная шрифтом Arial, ничем со смысловой точки зрения не отличается от “А”, написанной Helvetica. Значит ли это, что всякие “украшения” не важны и их можно никак не обозначать? Вообще-то, нет.
Думаю, многие знают, что в немецком языке есть символ ß. И это вовсе не “красивая буква B”, а две буквы “s”. В латышском языке имеется буква ķ, но это вовсе не обычная латинская “k” с чёрточкой для красоты, а отдельная буква. Поэтому “кот” будет именно “kaķis” (“катис”, а не то, что вы подумали). Больше того, в иврите казалось бы одна и та же буква, написанная в разных местах и в разном “стиле”, может иметь разное значение. Значит, информацию о “красивостях” тоже нужно хранить!
Кстати, тут есть ещё одна забавная тонкость: один видимый символ не обязательно соответствует одной кодовой точке Unicode. Например, букву é можно представить одним значением U+00E9, а можно двумя: U+0065 (обычная e) и U+0301 (комбинируемый знак ударения). На экране результат будет выглядеть одинаково, хотя внутри это совершенно разные последовательности. Такие последовательности кодовых точек, которые воспринимаются как один символ, называются графемными кластерами (grapheme clusters). Особенно весело становится с эмодзи: некоторые из них состоят из целой компании кодовых точек, хотя выглядят как одна картинка. Поэтому длина строки в байтах, кодовых точках и видимых символах — это три разные величины. И если ваша программа считает их одинаковыми, однажды вас ждёт весьма занимательный сюрприз.
В общем, ситуация с языками и алфавитами значительно сложнее, чем может показаться на первый взгляд. Именно поэтому рабочая группа Unicode потратила целую кучу времени на поиски решения, тем более, что тут есть и политические моменты, но нас это мало интересует.
Принцип работы Unicode
Суть данного стандарта такова. Каждой “обычной букве без особых излишеств”, то есть обычным “A”, “B”, и так далее, были присвоены специальные “магические числа”, записывающиеся в виде U+1234. Это магическое число — кодовая точка, U — понятное дело, Unicode, а сами цифры — шестнадцатиричные. Все эти кодовые точки можно найти на сайте Unicode, к примеру, U+00BF — это такой перевёрнутный знак вопроса, использующийся в испанском языке.
Отметим также, что Unicode не ограничивается 65 536 значениями. Стандарт предусматривает кодовые точки от U+0000 до U+10FFFF — всего 1 114 112 возможных значений. Часть этого пространства зарезервирована, и далеко не каждой кодовой точке назначен символ. Поэтому утверждение, что Unicode всегда использует только два байта, является мифом.
Правда, всё несколько сложнее, потому что Unicode позволяет модифицировать символы и получать новые комбинации. То есть к “просто буквам” можно добавлять комбинируемые диакритические знаки и акценты (типичный пример — знак ударения). Хотя для многих комбинаций есть уже готовые коды, можно собирать новые символы самостоятельно. Грубо говоря, если взять букву “е” и прилепить к ней две точки, получится “ё”. Ну, а букву “é” можно представить как U+0065 (обычная латинская “e”) и U+0301 (акцент, применяемый к предыдущей букве), как было описано выше. В принципе, это значит, что из любой “нормальной” буквы можно получить странного монстра Франкенштейна.
Давайте проведём небольшой эксперимент и создадим собственного монстра Unicode. Для этого воспользуемся Go и навесим на совершенно невинную латинскую букву e целую кучу комбинируемых знаков:
package main

import (
    "fmt"
    "unicode/utf8"
)

func main() {
    monster := "e"

    marks := []rune{
        '\u0301', // Острый акцент
        '\u0308', // Две точки сверху
        '\u0302', // Циркумфлекс
        '\u0303', // Тильда
        '\u0304', // Макрон
        '\u0327', // Седиль
        '\u0336', // Перечёркивание
        '\u0323', // Точка снизу
    }

    for _, mark := range marks {
        monster += string(mark)
    }

    fmt.Println("Наш монстр:", monster)
    fmt.Println("Байтов:", len(monster))
    fmt.Println("Кодовых точек:", utf8.RuneCountInString(monster))
}
В результате получится примерно такое чудовище (его внешний вид зависит от шрифта и программы, в которой вы читаете текст):
ȩ̶̣́̈̂̃̄
При этом наш Франкенштейн занимает 17 байтов в UTF-8 и состоит из 9 кодовых точек Unicode, хотя восприниматься может как один символ.
Подобные комбинации лежат в основе так называемого Zalgo text — текста, в котором на обычные буквы навешивают множество диакритических знаков, создавая эффект глючащей или проклятой надписи.
Кодировка UTF-16
Другой интересный вопрос состоит в том, как эти кодовые точки должны быть представлены в памяти или в сообщениях (в тех же электронных письмах), раз сам стандарт это строго не регламентирует. Для этого используются кодировки.
Первая идея была весьма простой — давайте хранить эти шестнадцатиричные числа в двухбайтовом виде! Тогда строка “Hello” будет представлена как U+0048 U+0065 U+006C U+006C U+006F, а в памяти — просто как 00 48 00 65 00 6C 00 6C 00 6F.
Такой подход использовался в UCS-2, где каждая кодовая точка представлялась двумя байтами. Однако довольно быстро выяснилось, что 65 536 значений недостаточно. Поэтому появилась UTF-16, которая использует одну или две 16-битные кодовые единицы. Для символов за пределами базовой многоязычной плоскости используются специальные пары значений, называемые суррогатными. Собственно, отсюда и пошёл миф, что в Unicode может быть только два байта, не более. То есть байта-то два, но только в конкретной кодировке, реализующей стандарт.
Но, с другой стороны, строку “Hello” можно написать и в ином виде, переставив байты местами: 48 00 65 00 6C 00 6C 00 6F 00. Иными словами, можно использовать вариант little-endian или big-endian — тут уж в зависимости от того, с чем будет сподручнее работать процессору. Выходит, форм хранения уже по крайней мере две! Как их тогда различать? Для этого можно добавить в начало потока данных специальную штуку под названием Byte Order Mark (BOM) — метку, сообщающую о порядке следования байтов. В UTF-16 она выглядит как FE FF для big-endian или FF FE для little-endian. Правда, BOM не обязателен: если порядок байтов известен заранее, например из явно указанной кодировки UTF-16LE или UTF-16BE, можно обойтись и без него.
Потом ожидаемо задались и другим вопросом: а чего нам хранить все эти лишние нули? Это особенно актуально для англоговорящих разработчиков, которые в основном использовали коды до U+00FF. С их точки зрения выходило, что для хранения строк приходится тратить в два раза больше места непонятно зачем. Это не говоря о том, что с дедушкиных времён осталась гора документов в ANSI и ещё бог знает в чём, и никому не хотелось это всё конвертировать. Короче, Unicode далеко не сразу получил широкое распространение, но часики-то оглушительно тикали, и ситуация становилась хуже.
Кодировка UTF-8
В 1992 году Кен Томпсон и Роб Пайк разработали UTF-8 — кодировку переменной длины, которая позволяла представлять символы Unicode, сохраняя совместимость с ASCII. Позднее стандарт дорабатывали, и в 2003 году RFC 3629 закрепил современный вариант UTF-8, использующий от одного до четырёх байтов (то есть Unicode != UTF8). Как подсказывает цифра 8, создатели предложили хранить данные в октетах (байтах), но их число варьируется в зависимости от кодовой точки. Иными словами, от U+0000 до U+007F (от 0 до 127) используется лишь один байт, от U+0080 до U+07FF — два байта, и так далее. Максимум — 4 байта информации, что позволяет закодировать весь миллион с хвостиком кодовых точек.
Это весьма удобно для документов в кодировке US-ASCII (United States), в которых как раз используются символы до U+007F, то есть каждый символ как раз кодируется одним байтом. Из этого следует, что такие документы выглядят одинаково что в ASCII, что в Unicode, то есть 65 — это “А” в обоих случаях. Поэтому на самом деле "A".ord в Ruby вернёт код буквы для UTF8 ("A".encoding почти наверняка сообщит как раз UTF8, во всяком случае, на любой нормальной системе).
Да, небольшая проблема заключается в том, что всему остальному миру всё равно пришлось подстраиваться под новый стандарт, но что поделать, ka ir tas ir. Справедливости ради, английский — язык международного общения, плюс программы тоже пишутся латинскими буквами.
Таким образом, появилось уже две кодировки: UTF16 и UTF8. Только в одной каждый символ занимал по 2 байта и надо ещё было разбираться, в какой последовательности эти байты записаны, а в другой многие “привычные” буквы занимали всего байт. Несложно догадаться, какая кодировка получила большую популярность.
Unicode и его многочисленные кодировки
Кстати, это не единственные варианты. Был такой зверь, как UTF-7, который позволял представлять Unicode с помощью семибитных последовательностей. Придумали его для старых почтовых систем, которые не умели нормально переваривать восьмибитные данные и могли по дороге что-нибудь испортить. Сейчас UTF-7 считается устаревшим и небезопасным, так что пользоваться им не стоит. Есть и UTF-32, где каждая кодовая точка занимает ровно четыре байта. Это упрощает некоторые операции с текстом, но с точки зрения экономии места выглядит довольно расточительно: даже несчастная латинская буква A отъедает целых четыре байта. UCS-4 — близкий исторический родственник UTF-32, но строго говоря, это не одно и то же.
Собственно, теперь мы понимаем, что всяких кодировок действительно придумали изрядное количество. Отсюда растут ноги у таинственных вопросительных знаков, которые можно периодически встретить в некоторых случаях — это символы, которые в данной кодировке не получается отобразить. Грубо говоря, можно взять любую кодовую точку из Unicode и попытаться отобразить в ASCII, но далеко не для всех чисел получится найти соответствие, что и приведёт к появлению весёлых вопросительных знаков.
Кодировку нужно чтить
Из всего этого получается интересный вывод: последовательность байтов, представляющая текст, фактически не будет иметь никакого смысла, если мы не знаем, какую кодировку она использует. Хотя мы всё равно используем термин “plain text”, он оказывается довольно размытым, потому что неясно, в какой-такой кодировке он “plain”. Если в нём используются любые символы после 127, то ASCII тут тоже не поможет. Именно поэтому при создании веб-страниц в теге meta мы указываем кодировку (а если не указываем, то стоило бы это делать) — аналогичная история с письмами.
Кстати, с веб-страницами вообще очень интересная штука. Кодировку HTML может сообщить сам веб-сервер через HTTP-заголовок Content-Type. Причём ничто не мешает ему указывать разные кодировки для разных страниц. Но иногда сервер не передаёт такую информацию, и тогда приходится полагаться на сам документ. Вот только, позвольте, как нам начать читать эту страницу, если мы ещё не имеем представления о её кодировке? Выходит замкнутый круг: чтобы прочитать страницу, нужно знать кодировку, а чтобы узнать кодировку, нужно начать читать страницу.
К счастью, для HTML предусмотрели выход из этой непростой ситуации. Объявление кодировки через <meta charset="UTF-8"> можно распознать ещё до полноценного декодирования документа. Правда, для этого оно должно целиком находиться в первых 1024 байтах файла. Если же кодировка указана в HTTP-заголовке, то он имеет приоритет над meta. Ну а если ни там, ни там ничего полезного нет, браузер может попытаться определить кодировку самостоятельно, и вот тут начинается веселье: вместо кириллических букв вполне могут вылезти какие-нибудь китайские иероглифы или другая абракадабра.
Поэтому, дамы и господа, мы с вами должны чтить кодировку. А в современных веб-проектах лучше вообще не мудрить и использовать UTF-8.